Indra OCR, 그래픽카드 없이 문서 글자를 읽는 도구
스캔해 둔 계약서나 사진으로 찍은 영수증에서 글자만 뽑아내려다 포기해 본 적이 있을 겁니다. 사진은 기계에게 색점 덩어리여서, 그대로는 검색도 복사도 되지 않습니다.
그림 속 글자 모양을 알아보고 글자로 바꿔 주는 일이 있습니다. 그걸 문자 인식, 영어 약어로 OCR이라고 부릅니다. 이 일은 오랫동안 느리거나, 빠르게 하려면 그래픽카드가 필요한 축에 들었습니다. 2026년 10월 13일 공개된 Indra OCR은 반대쪽을 잡았습니다. 그래픽카드 없이, 18메가바이트짜리 모델로, 보통 CPU에서 돌리는 것입니다.
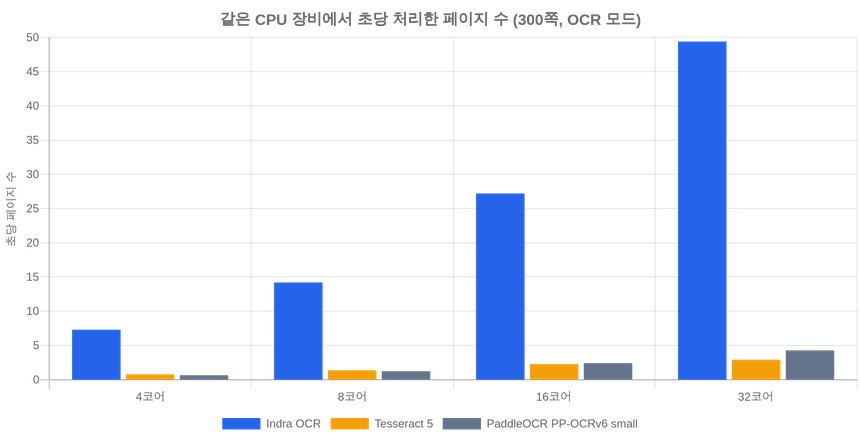
그래픽카드 없는 같은 x86 장비에서 같은 300쪽을 OCR 모드로 처리한 초당 페이지 수. 데이터: Indra OCR 저장소, Apache-2.0 — 그래프는 직접 작성
글자를 읽는 일은 사실 세 가지 일입니다
문서 한 쪽에서 글자를 뽑는 일은 한 덩어리가 아닙니다. 어디에 글자 줄이 있는지 찾고, 그 줄의 모양을 글자로 읽고, 읽은 줄을 사람이 읽는 순서대로 세우는 세 단계로 나뉩니다.
Indra OCR은 여기에 두 가지를 더 붙였습니다. 쪽이 뒤집혀 들어오면 바로 세우고, 제목·목록·표·각주 같은 덩어리에 이름표를 달아 마크다운으로 내보냅니다.
속도는 저장소가 공개한 자체 측정값으로 위 그래프와 같습니다. 코어 32개에서 초당 49.4쪽인데, 같은 조건의 Tesseract 5는 2.92쪽, PaddleOCR의 작은 글자 모델은 4.28쪽이었습니다. 각각 16.9배와 11.5배입니다.
다만 이 수치는 조건을 같이 봐야 합니다. Indra OCR 쪽만 3회 평균이고 비교 대상 둘은 1회 실행이며, 세 측정 모두 Indra OCR을 만든 쪽이 돌렸습니다.
속도는 모델을 줄여서 얻었습니다
저장소는 첫 실행 때 내려받는 모델이 약 18메가바이트라고 적었습니다. 그대로 믿지 않고 모델이 올라간 허깅페이스 저장소의 파일 목록을 받아 기본으로 받는 파일들의 바이트를 직접 더해 봤습니다. 18,298,172바이트, 약 18.3메가바이트로 서술과 맞았습니다.
| 파일 | 하는 일 | 크기 |
|---|---|---|
| rec_cjk.onnx | 중국 문자가 섞인 줄 읽기 | 9.3MB |
| rec.onnx | 줄을 글자로 읽기(주 인식기) | 5.0MB |
| order.onnx | 읽는 순서 세우기 | 3.0MB |
| det.onnx | 글자 줄 찾기 | 0.4MB |
| orient.onnx | 뒤집힌 쪽 바로 세우기 | 0.4MB |
| script.onnx | 줄의 문자 갈래 가려내기 | 0.2MB |
| meta.json | 글자 목록과 설정값 | 0.1MB |
| 합계 | 18.3MB |
줄을 글자로 읽는 주 인식기는 학습으로 조정되는 값이 약 100만 개라고 저장소가 밝혔습니다. 요즘 이야기되는 언어 모델이 수십억 개 단위인 것과 견주면 아주 작은 쪽입니다. 다만 값의 개수는 하는 일의 범위와 같이 봐야 합니다. 이 모델이 맡은 일은 대화가 아니라 잘라낸 한 줄의 글자 모양을 글자로 바꾸는 것 하나입니다.
파이토치 같은 덩치 큰 딥러닝 라이브러리를 함께 깔지 않고 ONNX 런타임이라는 가벼운 실행기만 쓰는 것도 같은 방향의 선택입니다. 수식을 읽는 기능은 기본으로 꺼져 있는데, 켜면 모델이 19.9메가바이트 더 내려오고 쪽당 시간도 늘어납니다.
한글은 사진으로는 읽지 못합니다
작게 만든 대가는 읽을 수 있는 글자의 범위입니다. 저장소는 스캔과 사진에서 읽는 문자를 라틴 문자(약 50개 언어)·키릴·그리스·데바나가리·벵골·중국 문자로 적었고, 한글은 그 목록에 없습니다.
얼마나 없는지 직접 확인했습니다. 인식기가 내놓을 수 있는 글자 목록은 모델과 함께 배포되는 설정 파일 안에 그대로 들어 있어서, 그 파일을 받아 글자를 세어 봤습니다.
| 문자 갈래 | 주 인식기 | 중국어 인식기 |
|---|---|---|
| 라틴·아스키 | 781 | 781 |
| 키릴 | 208 | 0 |
| 기호·문장부호 | 142 | 300 |
| 그리스 | 135 | 49 |
| 데바나가리 | 128 | 0 |
| 벵골 | 96 | 0 |
| 한자 | 0 | 8,836 |
| 한글 | 0 | 0 |
주 인식기의 한 글자짜리 글자가 1,490개인데 한글 음절도 한글 자모도 0개였습니다. 중국 문자가 섞인 줄을 따로 맡는 인식기도 9,967자 중 한글은 0개입니다. 원화 기호 ₩는 두 목록 모두에 있는데 '원'이라는 글자는 없습니다. 그래서 3,000₩는 부호화되고 3,000원은 '원'이 없어서 실패합니다.
저장소도 이 점을 한계 항목에 적어 두었습니다. 한글 줄은 못 읽는 데서 그치지 않고 엉뚱한 한자로 나온다고 했는데, 두 인식기 어디에도 한글이 없다는 사실과 맞물리는 서술입니다.
대신 다른 길이 하나 열려 있습니다. PDF 중에는 글자 데이터가 파일 안에 이미 들어 있는 것이 있습니다. 문서 프로그램에서 'PDF로 저장'해 만든 파일이 그렇고, 이 글자 데이터를 텍스트 레이어라고 부릅니다. Indra OCR은 기본 모드에서 쪽마다 이 레이어를 먼저 보고, 쓸 만하면 그대로 가져다 쓰고 없는 곳만 사진처럼 읽습니다. 레이어를 읽을 때는 문자 종류를 가리지 않습니다. 저장소는 75개 어족 1,125쪽으로 확인했고, 한국어를 포함한 모든 어족에서 레이어 글자의 98% 이상을 지켰다고 적었습니다.
한국 독자에게는 이 둘의 차이가 그대로 판단 기준이 됩니다. 한글 문서를 PDF로 저장한 파일이면 쓸 수 있고, 종이를 찍거나 스캔한 한글 문서라면 지금은 맞지 않습니다.
써 보려면, 라이선스가 두 겹입니다
설치는 파이썬 패키지 설치 명령 한 줄이고, 파이썬 3.10 이상이면 됩니다. 모델은 첫 실행 때 한 번 내려받아 두고 씁니다.
주의할 것은 라이선스가 한 겹이 아니라는 점입니다. 코드는 Apache 2.0이라 상업적 이용을 포함해 넓게 열려 있습니다. 그런데 실제로 글자를 읽는 모델 가중치는 조건이 다릅니다. 허깅페이스에 올라간 가중치의 라이선스 파일은 수정된 OpenRAIL-M이고, 저장소는 그 조건을 연구·개인 사용과 투자나 매출이 2천만 달러 미만인 스타트업에는 무료, 자사 API와 경쟁하는 용도로는 불가라고 요약해 두었습니다.
저장소 위쪽의 라이선스 배지 하나만 보고 넘어가기 쉬운데, 모델을 함께 받아 쓰는 도구에서는 코드와 가중치의 조건이 갈리는 일이 드물지 않습니다. 앞서 다룬 WayVoice도 라이선스 조건이 도구의 쓰임을 가른 사례였습니다.
별 205개를 어디까지 읽을 수 있나
공개 이틀치 별 추이(2026년 10월 15일 확인). 스타 추이: star-history
공개 이틀 만에 관심 표시인 별이 205개 붙었습니다. 다만 별은 관심의 표시이지 쓰는 사람의 수가 아닙니다. 같은 시점에 함께 확인되는 것은 포크 16개, 열린 이슈 2건, 그리고 파이썬 패키지 저장소에 올라간 배포 두 건(0.3.0과 0.3.1, 둘 다 10월 13일)입니다.
저장소를 만든 곳은 문서 변환 도구 Marker와 문자 인식 도구 Surya를 공개해 온 Datalab입니다. 별이 각각 4만 개와 2만 개가 넘는 저장소들이라, 처음 보는 이름이 올린 코드와는 성격이 다릅니다.
동시에 이 공개는 회사 제품으로 가는 입구이기도 합니다. 저장소 설명문은 손글씨나 상한 스캔처럼 이 도구가 못 하는 쪽을 자사 유료 플랫폼으로 안내합니다. 공개된 코드와 모델이 실제로 동작하는 것과, 그것이 제품의 앞문이라는 것은 둘 다 사실입니다.
못 하는 것이 분명한 도구입니다
저장소는 한계를 비교적 자세히 적어 두었습니다. 손글씨는 지원하지 않고(자체 시험의 손글씨 항목 약 8%), 낡고 흐린 스캔도 약 20%에 그칩니다. 셀이 합쳐졌거나 글자가 여러 줄로 넘어가는 복잡한 표는 칸이 어긋날 수 있고, 세로쓰기는 안 됩니다.
스스로 적은 것 중 눈에 띄는 대목도 있습니다. 쪽을 바로 세우는 기능이 똑바로 선 아랍어·히브리어 쪽의 절반쯤을 잘못 돌린다며, 그 문자에는 이 기능을 믿지 말라고 적었습니다.
정확도 수치에는 한 가지를 더 붙여 읽어야 합니다. 비교에 쓴 시험은 OmniParseBench라는 이름의 저장소인데, 같은 조직이 10월 9일에 공개한 것입니다. 자기 시험에서 자기 모델을 돌린 결과이고, 경쟁 도구와의 비교 실행도 저자들이 직접 했다고 밝혔습니다. 서로 다른 곳에서 돌린 결과가 쌓이기 전까지는 "이 시험에서는 이랬다"까지로 읽는 편이 맞습니다.
그래도 이 도구가 보여 주는 지점은 남습니다. 문서에서 글자를 뽑는 일 전부를 큰 모델 하나에 맡기지 않고, 줄 찾기·줄 읽기·순서 세우기로 쪼갠 뒤 각 조각에 작은 모델을 붙이면 그래픽카드 없는 장비에서도 돌아간다는 것입니다. 읽을 수 있는 문자를 줄인 것이 그 대가였고, 한글은 지금 그 바깥에 있습니다.
자료 출처
| # | 출처 | 확인한 것 |
|---|---|---|
| 1 | datalab-to/indra 저장소 | 2026-10-13 공개, Apache-2.0, 별 205·포크 16·열린 이슈 2(2026-10-15 발행 직전 확인) |
| 2 | 저장소 설명문 | 처리량·지연·정확도 수치와 측정 조건, 읽는 문자 목록, 한계 항목, 가중치 라이선스 요약 |
| 3 | 변경 기록 | 0.3.1까지의 변경, 수식 기능이 기본 꺼짐, 방향 보정 추가 |
| 4 | 코드 라이선스 파일 | Apache License 2.0 원문 |
| 5 | 모델 저장소 | 파일별 바이트 — 기본 7개 18.3MB, 수식 5개 19.9MB |
| 6 | 가중치 라이선스 파일 | 수정된 OpenRAIL-M 원문 |
| 7 | 모델 설정 파일(v3.1) | 글자 목록 직접 측정 — 주 인식기 1,490자·중국어 인식기 9,967자, 한글 0 |
| 8 | 파이썬 패키지 배포 | 0.3.0·0.3.1 모두 2026-10-13 업로드, 파이썬 3.10 이상 |
| 9 | OmniParseBench 저장소 | 비교 시험이 같은 조직 소유, 2026-10-09 생성 |
글자 목록 수치는 7번 파일을 내려받아 그 안의 글자 목록을 분류·집계한 값입니다. 모델 크기는 5번의 파일 목록에서 기본으로 받는 파일의 바이트를 더한 값입니다.
태그: AI, 오픈소스, Indra OCR, OCR, 문서 인식, PDF, 한글, 오픈소스 라이선스, CPU
'AI 소식' 카테고리의 다른 글
| 왓츠앱 도움말에 사람 눈엔 안 보이는 AI 지시문이 있었습니다 (0) | 2026.10.21 |
|---|---|
| 25년 묵은 암호 표준의 수수께끼 숫자, AI가 출처를 찾았습니다 (0) | 2026.10.20 |
| EmbeddingGemma 2, 글로 사진과 소리를 찾습니다 (0) | 2026.10.13 |
| WayVoice, 목소리를 내 컴퓨터 안에서만 글자로 바꾸는 도구 (0) | 2026.10.08 |
| seiso, AI가 쓴 문서를 기계가 검사하게 만든 규칙 (0) | 2026.10.03 |